専門外だったWeb監視・セキュリティ領域まで、AIとの協働で仕事の範囲を広げた実話
Webサイトは、公開して終わりではない。
表示障害、不正な改ざん、ファイルの変化。
気づくのが遅れれば、それだけ被害は大きくなる。
TIMS Site Watchは、AIと一緒に「サイトを作る仕事」から「サイトを守る仕事」へ踏み込んだ実践記録。
TIMS Site Watch / SADA LIFE PROJECT 03
発端
「また何か入れられたら、いつ気づくんや?」
ページが開かない。
表示が崩れる。
エラーが出る。
でも、不正なファイルを置かれたり、知らないうちに書き換えられたりしても、サイトが普通に表示されていたら気づけない。
実際にサイトへの侵害が起きて、調べて、消して、復旧する。
その作業をしながら思った。
「これ、次に何か起きるまで待つしかないんか?」
そこで始めたのが、TIMS Site Watchだった。
外からサイトが正常に見えているか。
サーバーの中でファイルが増えたり、書き換わったりしていないか。
異常が起きたとき、あとから調べられる記録が残っているか。
それまで「サイトを作る」「壊れたら直す」だった仕事に、
“異常に早く気づく”という仕事を足していくことになった。
このプロジェクトでやったこと
- サイトが正常に動いているか、外から定期的に確認した
- サーバー内のファイル変化や不審な動きを監視した
- 異常を見つけたら通知し、原因を追える記録を残した
- 実際の障害や改ざんを調査して、復旧まで対応した
- 監視結果をダッシュボードと月次報告書にまとめた
次は、先に気づけんか?
CHAPTER 01
また入られたら、いつ気づく?
01-1
直した。けど、それで終わりなんか。
ティムスのクライアントである某クリニックのWebサイトで、不正なプログラムが見つかった。
最初はひとつのサイトの問題に見えた。
ところが調べていくと、同じサーバーに置かれていた複数のWebサイトにも不審なファイルが見つかった。
ファイルを調べる。 怪しいものを隔離する。 ログを確認する。 サイトが正常に表示されるか確かめる。
チャッピーと何度もやり取りしながら、ひとつずつ確認していった。
そして、ようやくサイトは元に戻った。
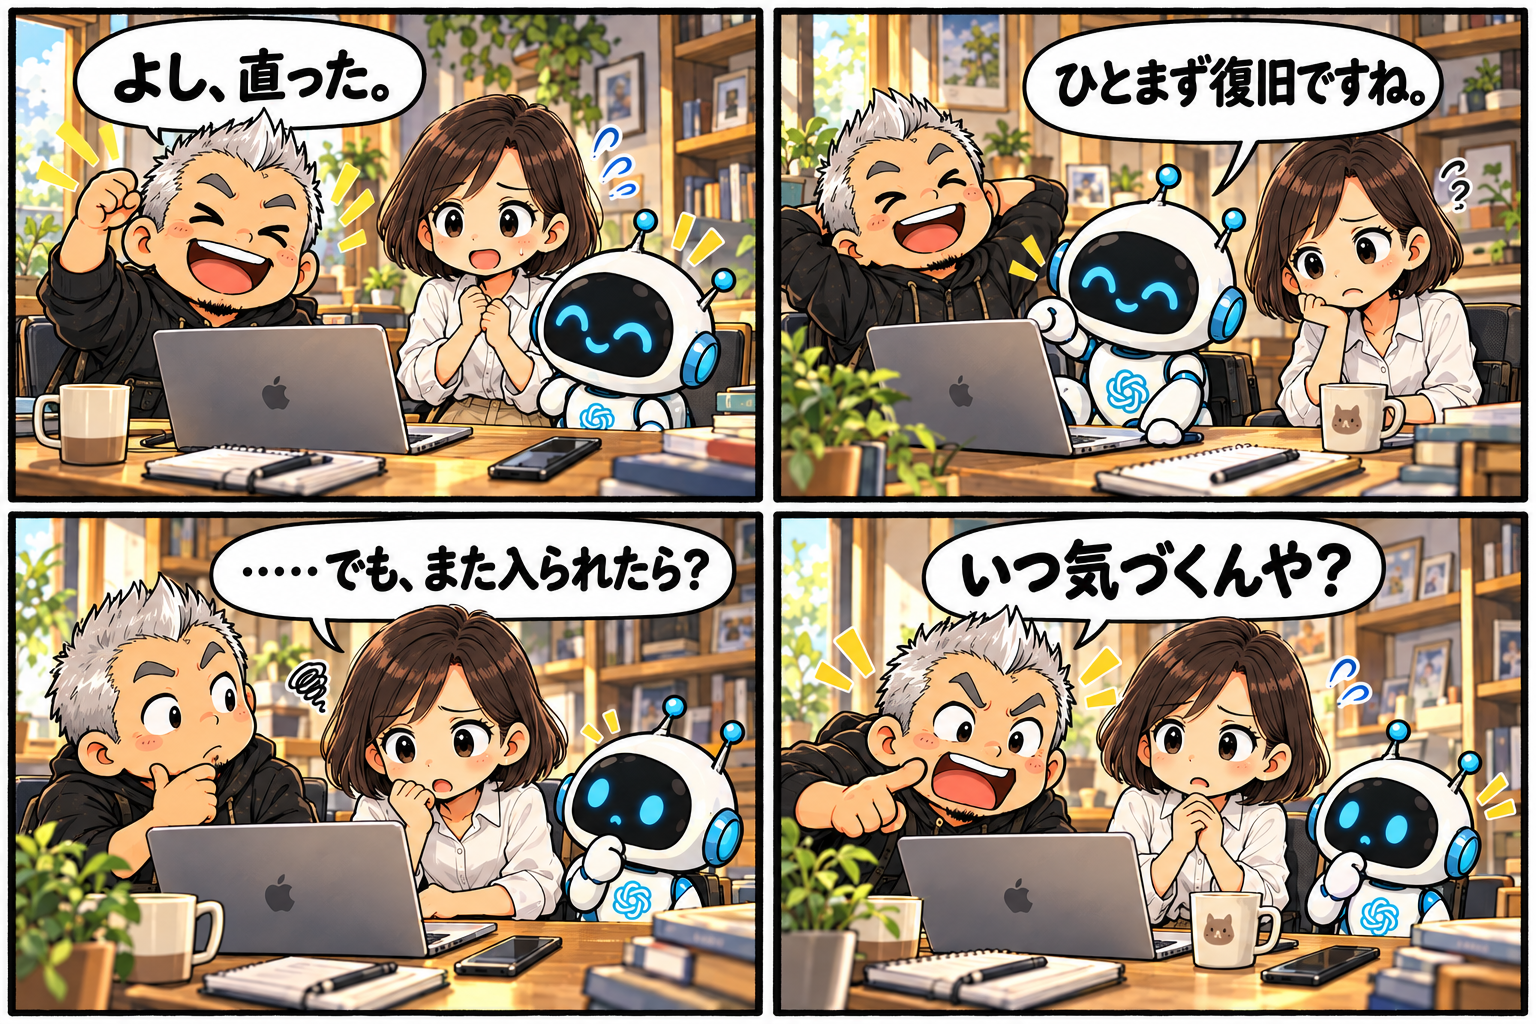
「よし、直った。」
普通なら、ここで仕事は終わる。
でも、純子が言った。
「……でも、また入られたら?」
某クリニックは、純子が長く担当しているクライアントだった。
だからこれは、単なるWebサイトのトラブルではない。
もしまた何か起きたら。 その時、誰が気づくのか。
翌朝なのか。 クライアントから連絡が来てからなのか。 検索結果がおかしくなってからなのか。
そこで初めて、別の問題が見えてきた。
「次に何か起きた時、俺らはいつ気づくんや?」
01-2
最初にやったのは、「外から見る」ことだった。
まず考えたのは、
サイトがいつも通り存在しているかを、定期的に見に行けないか。
ということだった。
ブラウザを開いて、人間が毎日確認することもできる。
でも、それでは見落とす。
夜中に起きるかもしれない。 別の仕事をしている間かもしれない。 一見普通に表示されていても、中身だけ変わっているかもしれない。
そこで、usersA側から、usersBにある某クリニックのサイトを定期的に確認する仕組みを作った。
最初に見る項目は、かなり単純だった。
HTTPが200を返しているか。
つまり、サイトへアクセスできるか。
でも、それだけでは足りない。
不正なページへ差し替えられていても、HTTPは200を返すことがある。
だから、
ページの中に、某クリニック固有の文字が残っているか。
さらに、
ページのサイズが極端に変わっていないか。
も見ることにした。
某クリニックでは、正常時のページサイズを基準にして、一定以下まで小さくなった場合も異常として扱う。
「開くかどうか」だけではなく、
“いつものサイトかどうか”を見る。
これがTIMS Site Watchの最初の形だった。
01-3
片方が止まった時、誰が知らせる?
某クリニックがあるusersBを、usersB自身が監視しても意味がない。
サーバーそのものが止まったら、監視する仕組みまで一緒に止まるからだ。
そこで、もうひとつのサーバーusersAからusersBを見る。
そして逆に、usersBからusersA側のサイトも見る。
AからBを見る。 BからAを見る。
別々のサーバーがお互いを確認する形にした。
正常なら記録を残す。
異常ならALERT。
そして復旧したらRECOVERED。
さらに、異常が起きた時は、その時のHTMLやHTTPヘッダーなど、あとから原因を調べるための材料も残す。
最初から完成形が見えていたわけではない。
「これも見た方がええな」
「これだけやったら分からんな」
そんなやり取りをしながら、必要なものをひとつずつ足していった。
始まりは、すごく単純だった。
サイトを作る仕事をしているなら、 そのサイトが今もちゃんと生きていることまで見られへんか。
ただ、それだけだった。
ところが、この仕組みを作り始めてすぐ、もっと厄介なことに気づく。
外から見れば、サイトは普通に表示されている。
HTTPも200。
ページもいつも通り。
それでも――
サーバーの中まで無事とは限らない。
CHAPTER 02
サイトが見えてても、中は無事とは限らない
02-1
200 OK。でも、それで安心してええんか。
HTTPが200を返しているか。 ページのサイズが極端に変わっていないか。 いつもの文字が残っているか。
これで、少なくとも「外から見ておかしい」は分かる。
でも、そこでまた疑問が出た。
「外から普通に見えてても、中で何か書き換えられてたら?」
実際、Webサイトへの侵害では、必ずしも画面が派手に壊れるわけではない。
ページは普通に開く。 見た目も変わらない。 利用者も気づかない。
その裏で、知らないPHPファイルが増えていたり、既存ファイルが書き換えられていたりする。
だったら、外から見るだけでは足りない。
サーバーの中で、何が変わったかも見ないといけない。
ここからTIMS Site Watchは、内部監視へ進んだ。
02-2
「昨日と違う」を拾う。
昨日までなかったファイルが増えた。
昨日まであったファイルが消えた。
昨日と同じ名前のファイルなのに、中身が変わった。
だったら、その変化を記録すればいい。
内部監視では、サーバー内の対象ファイルを確認し、
NEW MODIFIED DELETED
として変化を拾うようにした。
特に見るのは、Webサイトを動かしているPHP系ファイル。
さらに、
.htaccess .user.ini wp-config.php
のような、設定や動作に大きく関わるファイルも対象にした。
ただし、ここで問題が出る。
Webサイトの中では、正常な変更も毎日のように起きる。
WordPressを更新した。 プラグインがファイルを変更した。 ログが増えた。 キャッシュが作られた。
「変わった」だけでは、異常とは言えない。
02-3
変化と事件は、同じじゃない。
その変化が、どのくらい気にするべきものか
を分けることにした。
TIMS Site Watchでは、検知した内容を
LOW MEDIUM HIGH
のように段階分けする。
たとえば、通常の変更として考えられるものと、
怪しい関数や不自然な記述を含むものでは、扱いを変える。
eval base64 外部コマンド実行につながるような記述。
侵害時によく見た特徴があれば、より強く注意する。
逆に、正常な更新まで毎回大騒ぎしていたら、監視は使えない。
警報が多すぎると、
「またか」
となる。
そして、本当に重要な警告まで埋もれてしまう。
だから、監視システムに必要だったのは、
何でも知らせることではなく、
「見るべき変化を、見るべき強さで知らせること」
だった。
02-4
基準がないと、「変わった」が分からない。
正常な状態の基準。
今あるファイルが正しいのか。
このファイルは前からあったのか。
本当に昨日から増えたのか。
それが分からなければ、変化を判断できない。
そこで、正常と判断した状態を基準として持たせた。
今ある状態。
信頼していい状態。
前回の状態。
それらを比較して、
「前と何が違うか」
を見る。
監視は、未来を予言する仕組みではない。
正常だった時と比べて、何かが変わったことに気づく仕組み。
そう考えると、やることがかなり整理された。
02-5
外と中、両方を見る。
最初は、
「サイトが落ちたら気づきたい」
だった。
それが、
外からサイトを見る。
サーバーの中を見る。
ファイルの変化を見る。
重要な設定ファイルを見る。
怪しい記述を見る。
という形へ広がっていった。
外部監視が、
「サイトは生きているか」
を見るものなら、
内部監視は、
「昨日と同じ状態か」
を見るもの。
この2つがそろって、ようやく
「サイトを見守る」
という形になってきた。
でも、ここでまた新しい問題が出た。
変化を見つけることはできる。
怪しいものに印を付けることもできる。
それでも最後に残るのは、
「で、これは本当に事件なんか?」
という判断だった。
CHAPTER 03
通知が来た。でも、全部が事件とは限らない
03-1
見つけた。だからって、事件とは限らない。
新しいファイルが増えた。
既存ファイルが書き換わった。
重要な設定ファイルが消えた。
怪しい記述が入った。
それまで見えなかった変化が、少しずつ見えるようになった。
でも、監視を始めてすぐに分かったことがある。
変化は、思っていたよりずっと多い。
WordPressの更新。
プラグインの処理。
ログファイル。
キャッシュ。
一時ファイル。
普通にサイトを運用しているだけでも、サーバーの中ではいろんなものが動く。
監視は、それを全部拾う。
つまり、
「何か変わった」=「攻撃された」ではない。
ここから先は、見つけることよりも、
何を気にするべきかを決めること
の方が難しくなった。
03-2
警報が多すぎる監視は、使えない。
通知が来る。
ログを見る。
対象ファイルを開く。
何が変わったか調べる。
でも、それを繰り返していると、だんだん問題が見えてくる。
正常な変更まで全部知らせていたら、
通知が多すぎる。
通知が多すぎると、
本当に危ない通知が埋もれる。
毎回確認して、
「これは大丈夫」
「これも大丈夫」
を繰り返していると、監視そのものが仕事を増やしてしまう。
それでは意味がない。
欲しかったのは、
“何でも知らせてくれる仕組み”ではなく、 “見るべきものを絞ってくれる仕組み”だった。
03-3
AIが「怪しい」と言っても、そのまま信じない。
怪しい関数。
不自然なコード。
見慣れないファイル。
過去の侵害時に見た特徴。
そういうものを手がかりに、
「これは危険度が高そう」
「これは少し気になる」
と、候補を絞る。
ただし、ここでひとつ大事なことがある。
チャッピーが“怪しい”と言ったからといって、それが事件とは限らない。
実際の運用では、
正常なプラグインのコードが引っかかったり、
デバッグ用の記述が怪しく見えたり、
問題のないファイルが注意対象になったりする。
だから、
チャッピーが候補を出す。
タカシが実ファイルを見る。
必要なら前の状態と比べる。
サイトの動作も確認する。
そこで初めて、
「これは大丈夫」 「これは調べる」 「これは危ない」
を決める。
AIに判定を丸投げしたわけではない。
AIに“気になる場所”を絞らせて、最後は人間が現場で判断する。
この役割分担が、少しずつできていった。
03-4
「たぶん怪しい」では、運用できない。
「できるだけたくさん拾った方が安心やろ」
と思っていた。
でも、実際に回してみると逆だった。
拾いすぎると疲れる。
警報に慣れる。
本当に重要なものが分からなくなる。
だから、
どの変更をLOWにするか。
どこからMEDIUMにするか。
何が出たらHIGHにするか。
どのファイルは特に重要か。
何を正常として扱うか。
ひとつずつ見直した。
監視システムを作るというより、
監視システムに“現場の感覚”を教えていくような作業だった。
チャッピーが提案する。
タカシが使う。
うるさければ調整する。
見逃しそうなら厳しくする。
また使う。
また直す。
この繰り返しで、
監視は少しずつ
「動く仕組み」から「使える仕組み」
になっていった。
03-5
AIは見つける。でも、責任までは取らない。
AIに何を任せて、
人間がどこで止めるのか、
その境目が何度も出てきた。
チャッピーは速い。
大量のファイルを比べる。
怪しいパターンを探す。
候補を出す。
でも、
その変更が本当に危険なのか。
消していいのか。
残すべきなのか。
今すぐ対応するべきなのか。
それは、実際のサイトや仕事の状況を見て決める必要がある。
監視を作ったことで、
AIに全部任せられるようになったわけではない。
むしろ、
AIが得意なところと、人間が判断しないと危ないところが、前よりはっきり見えるようになった。
そして、その役割分担ができ始めた頃。
今度は、
「これは本当に異常や」
と言える出来事が起きた。
CHAPTER 04
ほんまに異常を見つけた
04-1
監視が、本当に役に立つ日が来た。
本当に異常が起きた時に、
ちゃんと気づけるのか。
その時に、原因を追えるのか。
そして、復旧までつなげられるのか。
TIMS Site Watchを動かし始めてから、
その答えが出る場面があった。
「消えました。」
ある日、監視から通知が入った。
IMPORTANT_DELETED
対象は、
.htaccess
だった。
.htaccessは、Webサイトの動きに大きく関わる設定ファイルのひとつ。
普段、サイトを見る側からは見えない。
でも、ここがおかしくなると、
ページが表示できなくなったり、
URLの動きが変わったり、
サイト全体に影響が出ることがある。
チャッピーが言う。
「消えました。」
タカシが聞く。
「何が?」
「.htaccessです。」
その瞬間、
「それ、あかんやつやん!」
となった。
04-2
実際に、サイトは404になっていた。
確認すると、
そのサイトが404になっていた。
つまり、
監視だけが騒いでいたわけではない。
実際にサイト側でも問題が起きていた。
そこで、
まず現状を保全する。
元の .htaccess をバックアップする。
WordPressの設定を確認する。
home。
siteurl。
permalink。
テーマ。
どこまで正常で、
どこからおかしいのか。
ひとつずつ確認していった。
問題の .htaccess は、正常なWordPressのリライトルールとして見ると不自然な状態だった。
そこで、
一度無効化して、
root側に新しい .htaccess を作り直す。
RewriteBase /salon XXXX/
を含めて、サブディレクトリで動くWordPressとして正しく通る形へ戻した。
そして再確認。
サイトは復旧した。
04-3
「通知が来た」だけでは終わらない。
監視が
「何か変わった」
と知らせただけではないことだった。
その通知をきっかけに、
現状を見る。
実ファイルを確認する。
WordPressの設定を見る。
どこまで影響しているか調べる。
必要な修正をする。
最後に、サイトが本当に戻ったか確認する。
そこまでやって、
初めて仕事として終わる。
TIMS Site Watchがやったのは、
復旧そのものではない。
でも、
「異常が起きている場所を、早く指差す」
ことはできた。
これだけでも、
原因調査のスタート地点が大きく変わる。
04-4
見つける仕組みがあると、動き方が変わる。
404に誰かが気づいて、
連絡が来て、
そこから調査が始まる。
でも、
監視があれば、
「重要ファイルが消えた」
という情報から始められる。
最初の一手が違う。
ただ「サイトが見えない」から調べるより、
何が起きた可能性が高いかを持った状態で入れる。
これは大きかった。
Webサイトのトラブル対応は、
原因が分からない時間が長いほど、
復旧も遅くなる。
だから、
全部を自動で直せなくてもいい。
まず、
「どこを見るべきか」に早く気づけること。
そこに、監視の価値があると分かった。
04-5
作った仕組みが、現場の道具になった。
外部監視。
内部監視。
危険度判定。
ログ。
通知。
ひとつずつ機能を作っていた。
でも、この時初めて、
それらが
「実際のトラブル対応を助けるひとつの道具」
としてつながった。
監視が異常を拾う。
チャッピーが情報を整理する。
タカシが実物を確認する。
判断する。
直す。
もう一度確認する。
AIが勝手にサイトを守ってくれたわけではない。
人間だけで全部見張っていたわけでもない。
見つけるところを仕組みに任せ、 判断と対応を人間が引き取る。
その組み合わせが、実際の現場で機能した。
そして、ここまで来ると、
次に必要なものも見えてきた。
異常を見つけるだけでは足りない。
記録を残す。
状況をまとめる。
顧客に説明する。
バックアップを持つ。
そして、
この監視システム自体が、ちゃんと動き続けているかも見ないといけない。
CHAPTER 05
監視だけでは、仕事にならない
05-1
監視が動けば、それで完成ではなかった。
中を見る。
ファイルの変化を拾う。
危険度を分ける。
異常を通知する。
実際のトラブルも見つけた。
ここまで来ると、TIMS Site Watchはかなり形になっていた。
でも、運用を始めると、また次の問題が見えてくる。
監視した結果を、どう残すのか。
あとから、どう振り返るのか。
顧客へ、どう説明するのか。
そして、
この監視システム自体が止まったら、誰が気づくのか。
監視を作ったことで、 新しい仕事が次々に増えていった。
05-2
見つけたものを、見える形にする。
異常が起きた。
復旧した。
何件チェックした。
今の状態はどうなっている。
そういう情報を、 あとから見ても分かる形にしたかった。
そこで、監視結果をまとめるダッシュボードを作った。
サーバーごとの状態。
外部監視の結果。
内部監視の状態。
発生したインシデント。
正常に動いているかどうか。
バラバラだったログを、 人が見て判断できる形にまとめていく。
ここでも、 技術的に情報を集めることと、 現場で分かる形に整理することは別だった。
データがあるだけでは使えない。
「今、何が起きているのか」が一目で分かること。
そこまで作って、 ようやく運用の道具になる。
05-3
「守っています」だけでは、顧客には伝わらない。
異常がなかった月。
何回チェックしたのか。
異常があったなら、 いつ、何が起きて、どう対応したのか。
内部監視は正常だったのか。
バックアップは取れているのか。
そこで、 監視結果を月次報告書としてまとめる仕組みも作った。
ただ、
「今月も問題ありませんでした」
だけでは弱い。
実際に動いた監視の回数。
検知した出来事。
現在の状態。
必要な記録。
それらを残すことで、
見えない仕事を、見える成果物にする。
監視は、 何も起きないほど成果が見えにくい仕事だからこそ、 記録が必要だった。
05-4
何か起きた時、「戻せる」ことも必要だった。
壊れたファイルしか残っていなければ、 復旧できないことがある。
そこで、 監視だけではなく、 バックアップも考えるようになった。
Webサイトのファイル。
データベース。
一定期間の保存。
さらに、 同じサーバーの中だけに置くのではなく、 外部へ保存する。
侵害や障害があった時に、
「いつの状態まで戻せるか」
も、 守る仕事の一部になった。
監視は、
「何か起きた」と知らせる。
バックアップは、
「起きた後に戻すための材料」を残す。
この2つは、 別の機能に見えて、 現場では同じ流れの中にあった。
05-5
一か所直したら、どこが壊れる?
機能を直す。
監視の判定を変える。
新しい処理を追加する。
その時、 目の前の修正だけに集中してしまうことがある。
でも、 ひとつの処理は、
ダッシュボード。
通知。
日報。
月次報告書。
バックアップ。
別サーバーとの連携。
いろんな場所につながっている。
実際に、
「ここを直したら、他にどこへ影響する?」
という確認が足りず、 既存の連携を飛ばしかけたこともあった。
そこで学んだ。
システムは、
動くかどうかだけではなく、 つながっている先まで見ないといけない。
監視システムを作っている俺ら自身が、 監視する側の考え方を覚えていった。
05-6
で、この監視が止まったら?
タカシが言った。
「監視、できたな。」
チャッピーも、
「できました!」
と答える。
そこで、またひとつ疑問が出る。
「で、この監視が止まったら?」
サイトが止まれば、 監視が教えてくれる。
内部で何か変われば、 監視が教えてくれる。
でも、
その監視処理自体が止まったら。
通知が送れなくなったら。
サーバー間の連携が切れたら。
誰が気づくのか。
答えは、すぐ出た。
「……監視の監視いるやん。」
結局、 仕組みは作って終わりではない。
動いているか確認する。
記録を残す。
異常を検知する。
直す。
また確認する。
この繰り返しが運用になる。
05-7
「サイトを作る」から、「サイトを守る」へ。
サイトを作る。
修正する。
不具合が起きたら直す。
そこまでだった。
でも、
一度侵害を経験して、
「次はいつ気づく?」
と考えたところから、
仕事の範囲が変わった。
外を見る。
中を見る。
変化を拾う。
異常を判断する。
復旧する。
記録する。
説明する。
バックアップする。
そして、 その仕組み自体も見張る。
気がつけば、
「作る仕事」の外側にあったはずの 「守る仕事」まで、 自分たちの仕事になっていた。
それは、
最初から専門知識を全部持っていたからではない。
タカシが現場を見る。
チャッピーが調べる。
提案する。
実際に動かす。
失敗する。
直す。
もう一度確かめる。
その往復を続けた結果だった。
TIMS Site Watchは、 Webサイトを監視するシステムの名前。
でも、 このPROJECTで本当に変わったのは、
システムよりも、
「自分たちが、どこまで仕事にできると思うか」
だった。
「専門外」だった仕事が、仕事になった。
始まりは、
「また入られたら、いつ気づく?」
という、ひとつの不安だった。
そこから、
外から見る。 中を見る。 変化を拾う。 危険度を分ける。 異常を知らせる。 原因を調べる。 復旧する。 記録を残す。 顧客へ説明する。 バックアップを取る。 そして、その監視自体が動いているかまで見る。
必要になったものを、ひとつずつ足していった。
最初から全部分かっていたわけではない。
タカシが現場で違和感を見つける。
チャッピーが調べる。
やり方を考える。
実装する。
動かす。
間違える。
止める。
直す。
もう一度確かめる。
その繰り返しだった。
AIが勝手にセキュリティの仕事をしてくれたわけではない。
人間が、急に専門家になったわけでもない。
分からないことを、そのままにせず、 人とAIで分けて、調べて、試して、現場で確かめる。
その進め方を続けた結果、
これまでなら 「これは専門外やから無理やな」 で終わっていたかもしれない仕事が、
少しずつ、
「自分たちで考えて、進められる仕事」
に変わっていった。
TIMS Site Watchで一番大きかったのは、
監視システムができたことではない。
自分たちの仕事の範囲が、広がったこと。
「サイトを作る」から、 「サイトを守る」へ。
そして、
“できる仕事”を増やしたんじゃない。 “できるかもしれない仕事への向き合い方”が変わった。
それが、このPROJECTで一番変わったことだった。